观前提醒
本文仅用于自身经验分享,无任何教导、引诱、教唆、制作外挂等违法行为。
本声明适用于 suzhiYOLO / suzhiCyolo 等由 su素质(以下简称"作者")发布的开源项目。 在下载、使用或修改本项目代码前,请仔细阅读以下条款。使用即表示您已同意本免责声明全部内容。
1. 项目性质
本项目 仅供学习、研究及技术交流使用,旨在帮助开发者理解:
- 内存读写与逆向工程原理
- 深度学习目标检测在游戏场景中的应用
- Windows / Android 平台下的系统编程与驱动开发
严禁将本项目或其衍生版本用于任何违反法律法规、游戏服务条款或破坏他人合法权益的场景。
2. 使用限制
使用本项目时,您同意并承诺:
- 不得 将本项目用于任何商业目的(包括但不限于出售、租赁、捆绑收费等);
- 不得 将本项目用于任何线上/线下游戏的作弊行为,或破坏游戏公平性的活动;
- 不得 利用本项目侵犯任何第三方的知识产权、隐私权或其他合法权益;
- 不得 绕过游戏运营商的反作弊系统(Anti-Cheat)进行非法数据修改;
- 不得 将本项目代码用于恶意软件、勒索病毒、间谍软件等非法开发行为。
3. 免责条款
3.1 无担保声明
本项目以 "按原样"(AS IS) 方式提供,作者不提供任何明示或暗示的担保,包括但不限于:
- 适销性(Merchantability)
- 特定用途的适用性(Fitness for a Particular Purpose)
- 无侵权(Non-infringement)
- 代码的正确性、稳定性、安全性或兼容性
3.2 风险自负
您理解并同意,使用本项目所产生的一切风险(包括但不限于账号封禁、设备损坏、数据丢失、法律责任、经济损失等)均由您自行承担。作者不对任何直接、间接、偶然、特殊或惩罚性的损害承担责任。
3.3 第三方依赖
本项目可能包含第三方开源库或工具,相关版权及许可条件请参考各自独立的许可文件。作者不对第三方库的安全性、合法性或性能负责。
4. 法律合规声明
- 用户应自行确认所在国家或地区的法律法规,确保使用本项目的合法性。
- 若本项目被用于违反游戏运营商服务条款的行为,作者不承担任何连带责任。
- 作者保留随时修改、更新或停止本项目维护的权利,恕不另行通知。
5. 开源许可证
本项目采用 MIT 许可证(或您实际使用的许可证),具体条款见项目根目录的 LICENSE 文件。
在遵守 MIT 许可的前提下,您有权使用、复制、修改、合并、发布、分发本项目代码,但必须保留原始版权声明和本免责声明。
6. 最终解释权
本免责声明的最终解释权归作者所有。如有任何疑问,可通过项目仓库的 Issue 或作者指定的联系方式进行咨询。
继续观看视为同意上述协议
环境配置
在使用 YOLO 框架前,我们需要先配置基础环境。
Python 环境(3.10+ 推荐):
pip install ultralytics
pip install onnxruntime          # CPU 推理
pip install onnxruntime-directml # GPU 推理(Windows,需要 DirectML 支持)
如果你只是跑 YOLO 训练,装好 ultralytics 就够了。ONNX Runtime 和 DirectML 是后面部署到 C++ overlay 时才需要的。
C++ 编译环境(可选,部署阶段才用):
- Visual Studio 2022 Build Tools(C++ 桌面开发工作负载)
- vcpkg 或 NuGet 安装
Microsoft.ML.OnnxRuntime.DirectML
具体内容可自行查询,不再赘述。
YOLO 的基础认知
有了环境,我们就可以来进行数据集的准备了。
不过,在准备前,我们需要了解下 YOLO 的推理机制,方便我们理解。
YOLO 的推理结果并不是直接返回"这是敌人"或"这是队友"这样的文字描述, 返回的是一个 检测结果数组(列表),数组中的每一个元素对应一个被检测到的目标。
对于一个目标,YOLO 会返回以下信息:
- class_id:一个整数,表示这个目标属于哪个类别。比如你训练时定义了
0=敌人、1=队友,那返回的class_id=0就代表"敌人"。 - confidence:0 到 1 之间的浮点数,表示模型认为这个目标有多大概率属于这个类别。例如
0.85表示模型有 85% 的把握这是一个敌人。 - bounding box:一组坐标,用在屏幕上把这个目标"框"出来。常见的表示方式有:
- 中心点坐标 + 宽高:
(center_x, center_y, width, height),四个值都在 0~1 之间(相对于图片尺寸的归一化坐标) - 左上角 + 右下角坐标:
(x1, y1, x2, y2),同样是 0~1 的归一化坐标
- 中心点坐标 + 宽高:
了解了个大概,就可以开始数据集的第一步:截图了。
截图工具已放到文章末尾,欢迎自取。
YOLO 数据集准备
首先,不要认为每一步都这么简单,对于新东西,我们保持严谨。
态度很重要。
虽然无非就是:
- 上游戏
- 打开工具
- 选窗口范围
- 开始截图
- 打两把,或者盯着队友转两圈
- 截图结束,下号
- 标注
但是,角度、距离、分辨率这些同样重要,缺一不可,少一个 YOLO 识别效率都会大打折扣。 而且,一个优秀的模型训练至少需要数以万张的高精度训练数据集,卓越的更是数不胜数。 仅靠双手,如何才能避免误框、多框、少框这个难题?
你觉得我会说:"我没有天赋,我只有坚持…… 加大数据量,一个个手动标注。" 但那是弱者的思维。
AI 标注工具:X-AnyLabeling
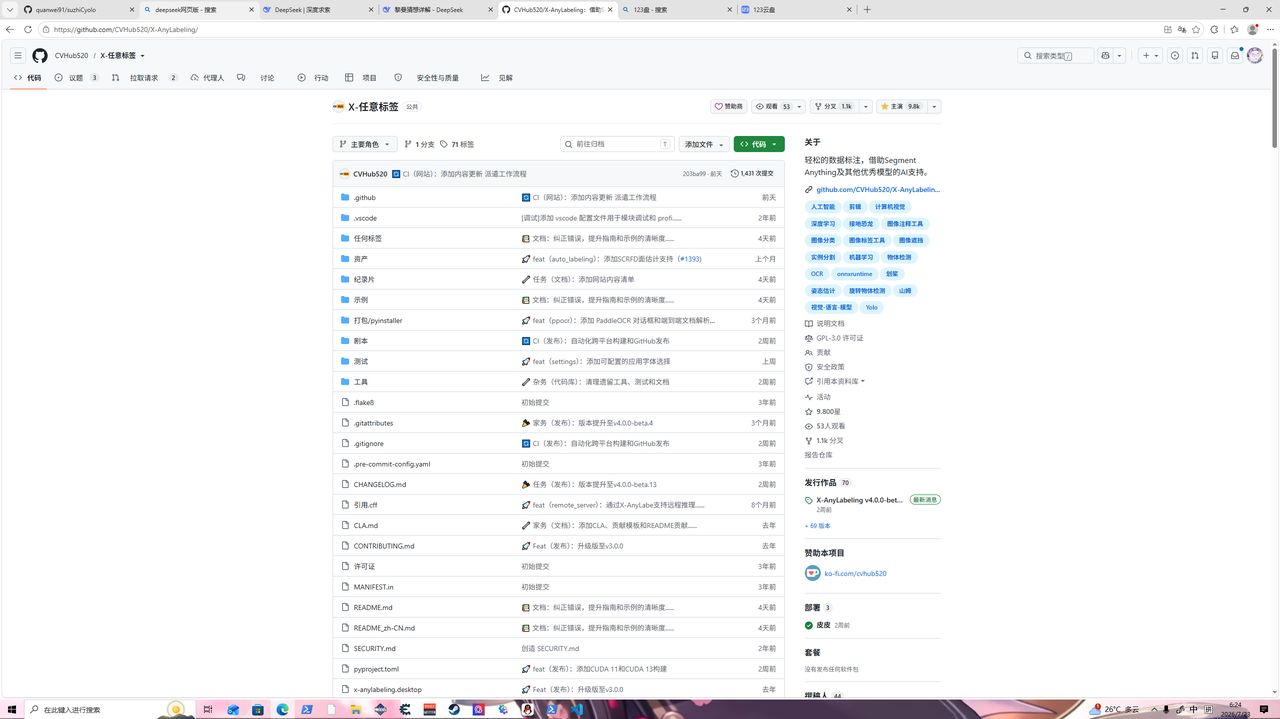
X-AnyLabeling 提供了一个非常之 nb 克拉斯的东西 —— AI 标注。
工作流程:
- 手动标注 10~20 张作为种子数据集
- 用这 10~20 张训练一个初始模型(哪怕精度一般也行)
- 把这个模型喂回 X-AnyLabeling,让它自动处理文件夹中剩余的图片
- 人工修正自动标注的结果,检查漏标、错标、多标
你只需要 10~20 张图,组成一个小数据集喂给一个模型,它就能直接帮你处理文件夹中剩余的图片,并转换为模型可用的数据集格式。
这将极大缩短我们标注、处理数据集的时间。
7月17日的素质 belike : 🤡
当然,工具虽好不要贪多。它虽然可以帮你处理绝大部分数据,但还是需要人工修正。 不然误标注对模型学习的影响也是很大的。
数据集目录与配置
参数说明
| 参数 | 含义 |
|---|---|
| path | 数据集的总目录,YOLO 会在这里找 train / val 子目录 |
| train / val | 训练/验证图片路径,可以是相对路径(如 images/train)、绝对路径或指向 .txt 文件(逐行列出图片路径) |
| nc | 类别数量(Number of Classes),整数 |
| names | 类别名称字典,键为类别 ID(从 0 开始),值为名称字符串 |
目录结构示例
my_data/                     # 这就是 path 指向的目录
├── images/
│   ├── train/               # 训练图片
│   │   ├── img1.jpg
│   │   └── img2.jpg
│   └── val/                 # 验证图片
│       ├── img3.jpg
│       └── img4.jpg
├── labels/
│   ├── train/               # 训练标签,与图片一一对应
│   │   ├── img1.txt
│   │   └── img2.txt
│   └── val/                 # 验证标签
│       ├── img3.txt
│       └── img4.txt
└── my_data.yaml             # 配置文件
my_data.yaml 示例
path: ./my_data       # 数据集根目录
train: images/train   # 训练集图片
val: images/val       # 验证集图片

nc: 2                 # 类别数量
names: ["head", "full"]  # 类别名称,索引对应 class_id
注意:标签文件名必须与图片文件名一一对应(仅后缀不同)。例如
img1.jpg对应img1.txt。
标签文件 *.txt 格式
每张图片对应的 .txt 标签文件里,每一行代表一个目标:
class_id x_center y_center width height
- class_id:类别 ID(整数,从0开始)
- x_center, y_center, width, height:归一化浮点数(0~1之间)
例如,一张 640x480 的图片里,有一个"敌人"在中心,宽高是 100x100:
class_id = 0
x_center = 320/640 = 0.5
y_center = 240/480 = 0.5
width = 100/640 = 0.15625
height = 100/480 = 0.20833
那么 .txt 文件里就是一行:
0 0.5 0.5 0.15625 0.20833
提示:X-AnyLabeling 导出时会自动生成这个格式的标签文件,不需要手算。
YOLO 的训练
弄完了漫长的数据集,接下来就要喂给初始模型了。
依旧 YOLOv8n,轻量、够用。
训练脚本(Python)
在项目根目录新建 train.py:
from ultralytics import YOLO

# 加载预训练模型
model = YOLO("yolov8n.pt")

# 开始训练
results = model.train(
    data="my_data.yaml",        # 数据集配置文件
    epochs=100,                 # 训练轮数
    imgsz=320,                  # 输入图片尺寸
    batch=8,                    # 批大小
    device=0,                   # GPU ID,CPU 用 device="cpu"
    workers=4,                  # 数据加载线程数
    patience=50,                # 早停轮数
    optimizer="auto",           # 优化器(auto 自动选)
    lr0=0.01,                   # 初始学习率
    momentum=0.937,             # 动量
    weight_decay=0.0005,        # L2 正则化
    warmup_epochs=3,            # 预热轮数
    warmup_momentum=0.8,
    warmup_bias_lr=0.1,
    box=7.5,                    # 边界框损失权重
    cls=0.5,                    # 分类损失权重
    dfl=1.5,                    # 分布焦点损失权重
    hsv_h=0.015,                # 色相增强
    hsv_s=0.7,                  # 饱和度增强
    hsv_v=0.4,                  # 明度增强
    translate=0.1,              # 平移
    scale=0.5,                  # 缩放
    fliplr=0.5,                 # 左右翻转
    mosaic=1.0,                 # Mosaic 增强
    mixup=0.0,                  # Mixup 增强
    project="runs/train",       # 结果保存目录
    name="suzhiyolo_exp",       # 实验名
    exist_ok=True,              # 覆盖同名目录
    amp=True,                   # 混合精度
    plots=True,                 # 生成曲线图
    val=True,                   # 边训练边验证
)

print("✅ 训练完成,模型保存在:", results.save_dir)
参数详解(训练)
核心参数
| 参数 | 含义 | 说明 |
|---|---|---|
| data | 数据集配置文件 | YAML 路径,指定了数据位置和类别 |
| model | 预训练权重 | 选 yolov8n.pt 最轻量,显存不够就用它 |
| epochs | 训练轮数 | 配合 patience 早停,不是越多越好 |
| imgsz | 输入图片尺寸 | 320 速度最快,640 精度更高,显存约 4 倍 |
| batch | 批大小 | 受显存限制,6G 推荐 8,12G 可上 16 |
| device | 设备 | 0 表示第一张 GPU,cpu 表示 CPU |
优化器参数
| 参数 | 含义 | 说明 |
|---|---|---|
| lr0 | 初始学习率 | 默认 0.01,震荡明显可降到 0.005 |
| momentum | 动量 | SGD 使用,默认 0.937,加速收敛 |
| weight_decay | L2 正则化 | 防止过拟合,默认 0.0005 |
| optimizer | 优化器 | auto 自动选(SGD for YOLO),也可指定 AdamW |
| warmup_epochs | 预热轮数 | 前几轮 lr 从小变大,避免初期震荡 |
损失权重
| 参数 | 含义 | 说明 |
|---|---|---|
| box | 边界框损失权重 | 默认 7.5,决定框的位置准不准 |
| cls | 分类损失权重 | 默认 0.5,决定类别判断准不准 |
| dfl | 分布焦点损失权重 | 默认 1.5,影响边框回归的精细度 |
数据增强(重要)
| 参数 | 含义 | 说明 |
|---|---|---|
| hsv_h/s/v | 色相/饱和度/明度扰动 | 增强对光照变化的鲁棒性 |
| translate | 平移 | 模拟目标在画面不同位置 |
| scale | 缩放 | 模拟目标远近变化,我开 0.5 |
| fliplr | 左右翻转 | 默认 0.5,对对称场景有用 |
| mosaic | 马赛克增强 | 将 4 张图拼成 1 张,默认 1.0,建议保留 |
| mixup | 混合增强 | 两张图叠加,适合小数据集 |
训练管理
| 参数 | 含义 | 说明 |
|---|---|---|
| patience | 早停轮数 | 验证集 mAP 连续 N 轮不提升就停止 |
| project | 结果根目录 | 默认 runs/train |
| name | 实验子目录 | 每次训练单独存一份,方便对比 |
| exist_ok | 覆盖允许 | True 则覆盖同名目录,False 则自动加后缀 |
| resume | 断点续训 | 填 True 或具体权重路径 |
| amp | 混合精度 | 开启后显存占用降低约 30%,速度提升 |
| plots | 生成曲线图 | True 自动生成 loss/mAP 曲线图 |
训练过程看什么
终端日志重点关注:
Epoch   GPU_mem   box_loss   cls_loss   dfl_loss   mAP50   mAP50-95
  1/100   4.8G      1.25       2.63       1.91     0.12     0.08
 20/100   5.1G      0.92       1.24       1.54     0.43     0.27
 50/100   5.2G      0.73       0.81       1.32     0.61     0.39
100/100   5.2G      0.61       0.58       1.18     0.72     0.48
box_loss/cls_loss/dfl_loss持续下降 → 模型在学- mAP50:0.6 以上基本可用,0.7+ 算不错
- mAP50-95:更严格,0.4~0.5 正常
如果 loss 降但 mAP 不动 → 数据标注有问题或类别不平衡。 如果 mAP 涨到某点后开始下降 → 过拟合,提前停或减 epochs。
导出 ONNX 模型
训练完成后,YOLO 会在 runs/train/suzhiyolo_exp/ 下生成 best.pt。
但 C++ 端不能直接用 .pt 文件,需要导出为 ONNX 格式。
from ultralytics import YOLO

model = YOLO("runs/train/suzhiyolo_exp/best.pt")

model.export(
    format="onnx",
    imgsz=320,
    opset=17,          # ONNX opset 版本,17 兼容性好
    simplify=True,     # 简化模型图,减小体积
)
导出后会在同目录下生成 best.onnx,这就是我们 C++ overlay 要加载的模型文件。
suzhiCyolo:开箱即用的 C++ Overlay
经过上述流程,我们已经得到了一个能识别头部/全身的 YOLO 模型(best.onnx)。
现在,我们需要给它造一副身体 —— 一个 C++ overlay 程序,让模型真正在屏幕上跑起来。
suzhiCyolo 做了什么?
- 基于 ImGui + DirectX 11 的透明 overlay,实时渲染在游戏窗口上方
- 加载你训练好的
yolov8n.onnx,通过 ONNX Runtime + DirectML 在 GPU 上推理 - 支持多种瞄准算法(直接瞄准 / 卡尔曼滤波 / 线性插值)
- IoU 跟踪器,稳定锁定目标,减少跳帧
- 动态瞄准范围,距离越近范围越小,避免贴脸甩枪
不想从 0 开始写?没问题,suzhiCyolo 提供开箱即用包,导入你自己的模型即可开始使用。
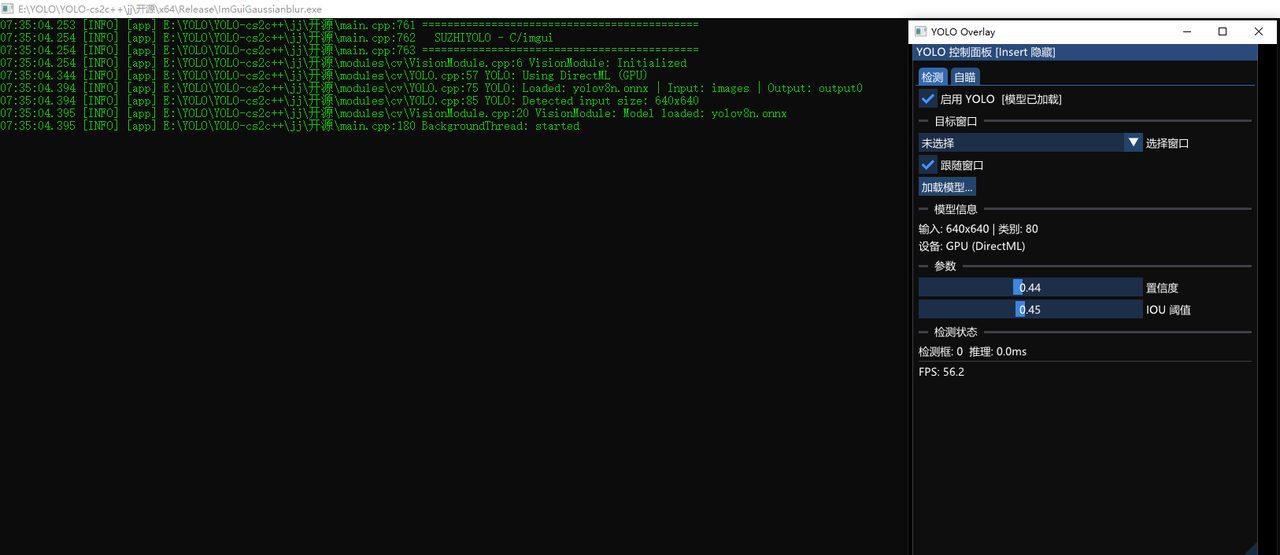
具体用法参考 suzhiCyolo 仓库。
截图建议
截图是数据集质量的根基,这里给几个实用建议:
- 多地图、多角度:不同地图的光照、背景差异很大,只截一张图训练出来的模型换个地图就瞎
- 固定分辨率:训练和推理的分辨率要一致,别拿 1920 的截图训练、用 1280 的窗口推理
- 多姿态:蹲下、站立、跳跃、持枪、不持枪,每种姿态都要覆盖
- 距离梯度:近处、中距离、远处各截一些,模型才能学会不同距离的识别
- 数量建议:至少 500 张起步,1000~3000 张效果明显提升,5000+ 趋于稳定
工具
截图工具
X-AnyLabeling
GitHub - CVHub520/X-AnyLabeling